Kostenlos / Open SourceJede Website per Prompt statt Selektoren in strukturiertes JSON verwandeln

KI-Agenten per natürlicher Sprache mit jeder Website verbinden
Geschätzte monatliche Website-Besuche
Similarweb-Schätzungen für diese Domain, keine aktiven Nutzer. Nur Monate mit Beobachtungen werden gezeigt; Erfassungsdatum und Messzeitraum sind getrennt.
Erfasst am 11.11.2026

Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist AgentQL (agentql.com) eine KI-Plattform, die unter AI Agent indexiert ist und 13.100 monatliche Besuche mit einem Traffic-Delta von -10.303 (-44 %) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Vereinigte Staaten (33 % Traffic-Anteil) und sie arbeitet mit einem Preismodell „Freemium, Kostenlose Testversion, Kostenpflichtig, Preise auf Anfrage“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören ScrapeGraphAI (91.362 Besuche/Monat), Exa (1,06 Mio. Besuche/Monat), Anakin (76.886 Besuche/Monat).
Nie wieder kaputte XPath-Pfade. Absolut genial.
Erleichtert Web-Scraping ungemein.
Gutes Tool, aber Preis ist stolz.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
Beschreiben Sie die gewünschten Daten in einfachen Worten, und AgentQL findet sie – ohne handgeschriebenes XPath, CSS-Selektoren oder Regex.
Abfragen liefern konsistente Ergebnisse trotz dynamischer Inhalte, Layoutänderungen und Redesigns.
Integration mit Playwright und Headless-Browsern, um Seiten zu steuern und strukturierte Daten in einem Workflow zu extrahieren.
Rufen Sie öffentliche Daten von jeder URL ab, ohne einen Browser zu starten – ideal für serverseitige geplante Jobs.
Extrahieren Sie schwer zugängliche Tabellen aus PDFs und optimieren Sie Abfragen in Echtzeit per Browser-Erweiterung.
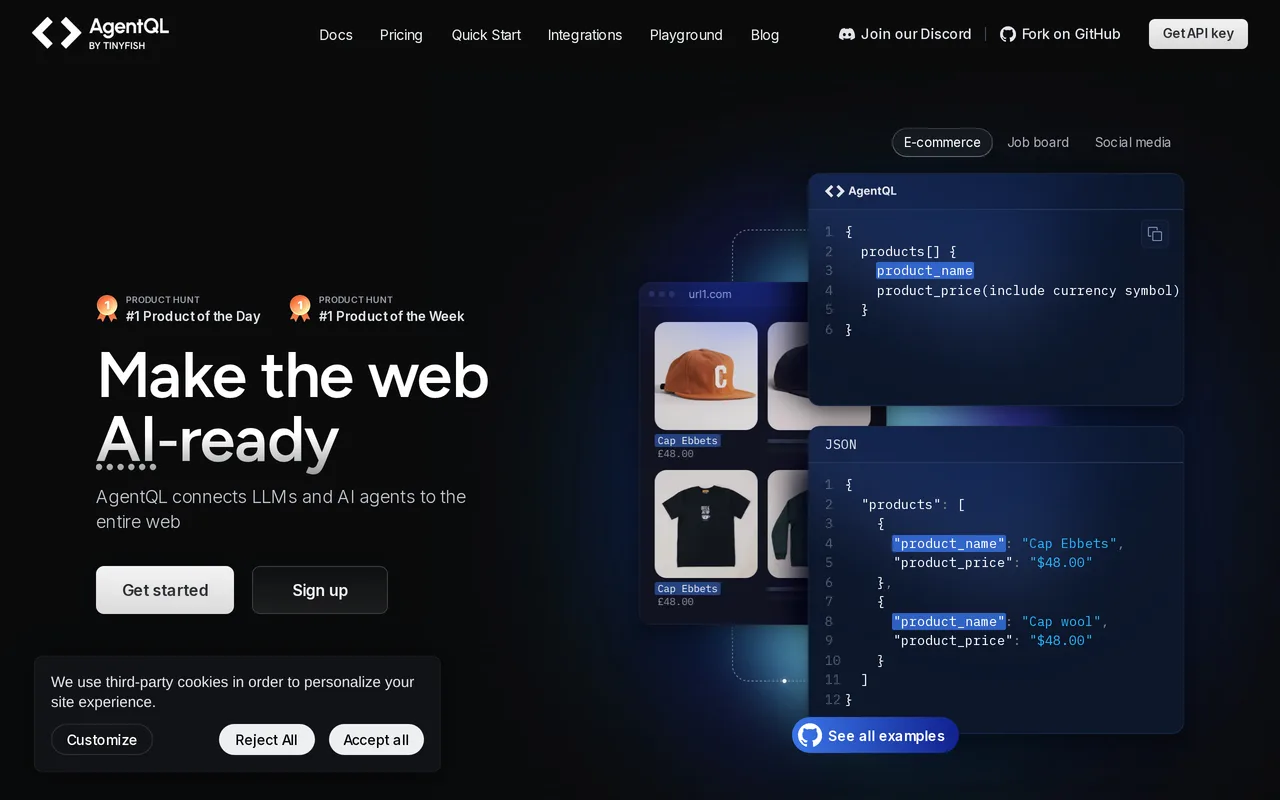
AgentQL von TinyFish ist ein Toolkit, das KI-Agenten und Anwendungen mit dem offenen Web verbindet. Kern ist eine deklarative Abfragesprache: Sie beschreiben die Form der benötigten Daten – etwa product_name und product_price – und AgentQL lokalisiert diese Elemente auf jeder Seite, öffentlich oder authentifiziert, ohne fragile XPath- oder CSS-Selektoren pflegen zu müssen. Da KI die Seitenstruktur statt fester Pfade versteht, funktioniert dieselbe Abfrage auch nach einem Redesign.
Das Produkt umfasst mehrere Oberflächen. Python- und JavaScript-SDKs integrieren sich in Playwright und Headless-Browser, sodass Sie echte Seiten steuern und strukturierte Daten in einem Ablauf extrahieren. Ein Browser-Erweiterungs-Debugger erlaubt die Live-Iteration von Abfragen auf jeder Website, während die REST-API (browserlos) öffentliche Daten von einer URL ohne Browser abruft. AgentQL parst zudem schwierige PDF-Inhalte wie Tabellen und speist sie in dieselbe strukturierte Pipeline ein.
AgentQL richtet sich an Teams, die Web-Agenten, Scraping-Pipelines und Daten-Workflows bauen. Es gibt eine kostenlose Stufe für Prototypen mit einer festgelegten Zahl an API-Aufrufen und Remote-Browser-Stunden, kostenpflichtige Pläne für höheren Durchsatz und Parallelität sowie eine Enterprise-Option mit verwalteten Datensätzen, dedizierten Cloud-Umgebungen und On-Premise-Deployment.
Schreiben Sie wiederverwendbare AgentQL-Abfragen, die Produkt-, Preis- oder Listendaten über viele ähnliche Seiten ohne seitenspezifische Skripte sammeln.
Speisen Sie aufbereitete strukturierte Seiteninhalte in das LLM, damit Agenten auf realen, aktuellen Informationen statt auf halluziniertem HTML agieren.
Planen Sie browserlose REST-API-Jobs, um öffentliche Daten von Ziel-URLs zu sammeln und in nachgelagerte Systeme zu laden.
Nutzen Sie das SDK zum Anmelden, Navigieren und Extrahieren aus privaten oder Login-geschützten Seiten mit robusten Abfragen.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | AgentQL | 13.100 | -44 % | 40% direkt | Freemium, Kostenlose Testversion, Kostenpflichtig, Preise auf Anfrage | Aktuell |
| 1 | ScrapeGraphAI | 91.362 | -25,7 % | 25% direkt | Freemium, Kostenpflichtig, Preise auf Anfrage | vs ScrapeGraphAI |
| 2 | Exa | 1,06 Mio. | +16,8 % | 57% direkt | Freemium, Preise auf Anfrage | vs Exa |
| 3 | Anakin | 76.886 | -31,6 % | 44% direkt | Freemium | vs Anakin |
| 4 | Dumpling AI | 18.752 | +27,8 % | 41% direkt | Freemium | vs Dumpling AI |
| 5 | Firecrawl | 1,83 Mio. | -1,9 % | 40% direkt | Freemium, Preise auf Anfrage | vs Firecrawl |
| 6 | TinyFish | 1,12 Mio. | +199,7 % | 36% direkt | Freemium, Preise auf Anfrage | vs TinyFish |
Kostenlos / Open SourceJede Website per Prompt statt Selektoren in strukturiertes JSON verwandeln

Exa is a search API and web research tool designed for AI applications. It gives agents clean, structured, real-time web data with semantic search, crawling, enrichment and deep research from a single endpoint.

Eine einzige Scraping-API, die jede Website in agententaugliches JSON verwandelt

Scraping-, Such- und Anreicherungs-APIs für KI-Agenten
Kostenlos / Open SourceWeb-Daten-API, die jede Website in KI-fertige Inhalte verwandelt

Ein API-Schlüssel für Websuche, Abruf, Browsen und Automatisierung von KI-Agenten

Webdaten-Infrastruktur für Scraping, Proxys und KI-fertige Datensätze

SpezialisiertProxies und Webdaten-APIs für Scraping und KI-Pipelines

Tausende fertige Scraper und KI-Agenten in einer Cloud ausführen

Cloud-Browser für KI-Agenten, Scraping und Automatisierung, die nicht blockiert werden

Web-Scraping-API mit integrierten Proxys, Browsern und Anti-Bot-Behandlung