01
Jina AIOffiziell
280.782/Monat
Eine Suchbasis aus Embeddings, Rerankern und Reader-APIs
KI-SuchmaschineRedaktionswert: 4.7Freemium, Kostenpflichtig51% direkt

Freemium, Kostenpflichtig

Vollständig verwaltete KI-Suche und RAG-Infrastruktur für Entwickler
Geschätzte monatliche Website-Besuche
Similarweb-Schätzungen für diese Domain, keine aktiven Nutzer. Nur Monate mit Beobachtungen werden gezeigt; Erfassungsdatum und Messzeitraum sind getrennt.
Erfasst am 11.11.2026
Das ist die Einschätzung unserer Redaktion auf einer Skala bis 5, kein Durchschnitt von Nutzerbewertungen. Die Sichtweisen auf dieser Seite hat eine KI aus den bekannten Produktinformationen zusammengefasst. Es sind keine Kundenrezensionen.
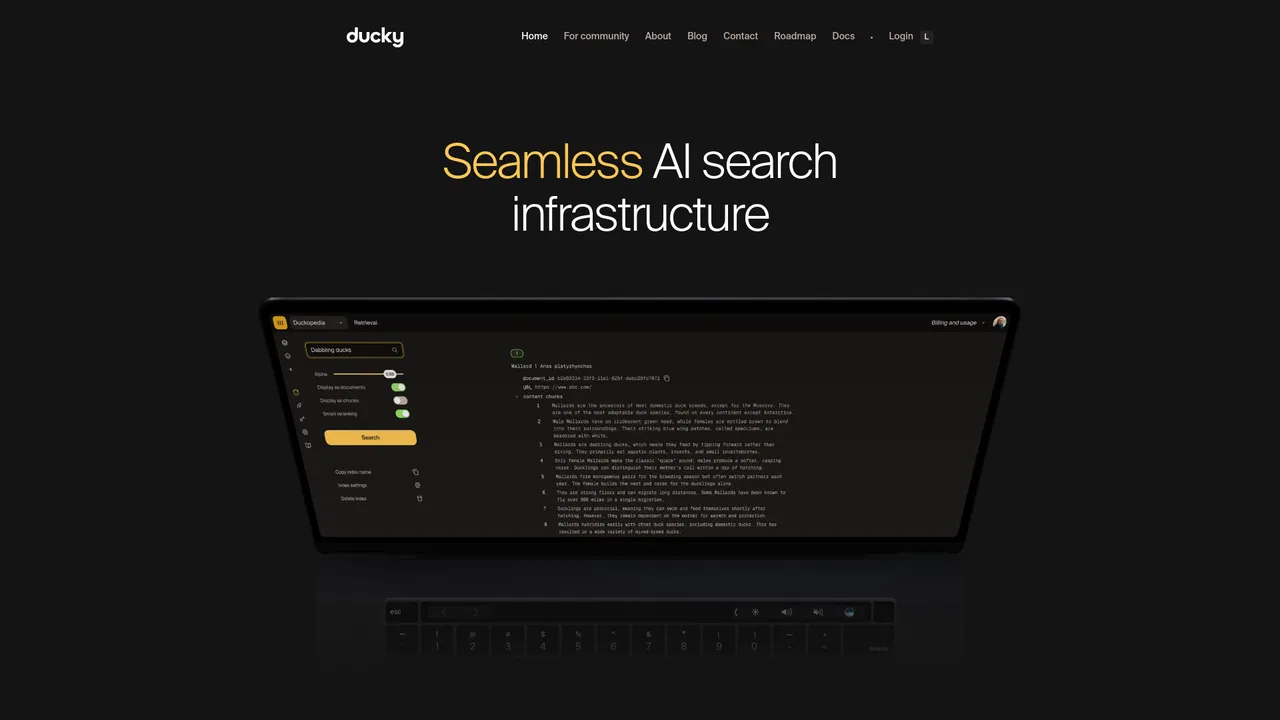
Laut der am 2026-11-11 verifizierten Telemetrie von OpenAITools.app ist Ducky (ducky.ai) eine KI-Plattform, die unter KI-Suchmaschine indexiert ist und 1966 monatliche Besuche mit einem Traffic-Delta von -181 (-8,4 %) gegenüber dem Vormonat generiert. Ihr primärer geografischer Markt ist Vereinigte Staaten (100 % Traffic-Anteil) und sie arbeitet mit einem Preismodell „Freemium“. Zu den wichtigsten konkurrierenden Alternativen nach monatlichem Volumen gehören Jina AI (280.782 Besuche/Monat), Pinecone (286.732 Besuche/Monat), Zilliz (108.886 Besuche/Monat).
Spart wochenlange Vektor-Datenbank-Fummelei.
RAG-Pipeline stand in Minuten.
KI-synthetisierte Perspektiven auf Basis von Live-Prüfung, Preisstruktur und Kategorie-Benchmarks — keine echten Einzelkundenbewertungen.
Text, Bilder und PDFs mit einer einzigen API indexieren und durchsuchen, damit Inhalte unabhängig vom Format auffindbar bleiben.
Ducky teilt und optimiert Dokumente für das Retrieval und wendet mehrstufiges Reranking an, damit die besten Treffer zuerst erscheinen.
Ergebnisse präzise nach Attributen wie Datum, Kategorie oder Tag eingrenzen und produktreife gefilterte Suchen bauen.
Agenten stellen Fragen und erhalten synthetisierte Antworten mit Quellenangabe, während die gesamte Pipeline automatisiert läuft.
Developer-first-Tooling mit dokumentierten APIs und erstklassigen SDKs für die zwei gängigsten Produkt-Stacks.
Ducky ist eine verwaltete Retrieval-Schicht, die die gesamte KI-Suchpipeline übernimmt – von der Aufnahme und Indexierung über Chunking und Reranking bis zur Antwortsynthese. Teams müssen nicht mehr Vektordatenbank, Embedding-Modell, Chunker und Reranker zusammenstückeln: Sie rufen eine einzige API auf, den Rest verwaltet Ducky. Die Plattform verspricht einen Start ohne Konfiguration: Inhalte anbinden, intelligenten Standardeinstellungen vertrauen und noch in derselben Woche eine funktionierende Suchfunktion ausliefern.
Über reines Keyword-Matching hinaus unterstützt Ducky multimodale Inhalte – Text, Bilder und PDFs –, sodass ein Index Fragen über verschiedene Dokumenttypen hinweg beantworten kann. Hinzu kommen Metadatenfilter für präzise Eingrenzung (Daten, Kategorien, Tags), mehrstufiges Reranking, das die besten Treffer nach oben schiebt, und agententaugliche Antwortgenerierung mit Quellenangabe. Ducky bewirbt außerdem Kontextfilterung: Irrelevante Passagen werden entfernt, bevor sie das LLM erreichen, was laut Anbieter den Tokenverbrauch deutlich senkt und Halluzinationen reduziert, indem Agenten in präzisen Kontext eingebettet werden.
Das Produkt ist Developer-first konzipiert: dokumentierte APIs, Python- und TypeScript-SDKs, ein öffentliches GitHub-Repository und ausführliche Entwicklerdokumentation. Eine klickbare Browser-Demo und ein Demo-Buchungsflow erlauben es, die Qualität vor einer Festlegung zu prüfen. Die Abrechnung erfolgt nutzungsbasiert mit einer kostenlosen Teststufe und einer kostenpflichtigen Launch-Stufe, sodass kleine Prototypen kostenlos starten und in Produktions-Retrieval-Lasten hineinwachsen.
Semantische, multimodale Suche in ein Live-Produkt bringen, ohne Vektordatenbank und Embedding-Pipeline zu bauen oder zu betreiben.
Mithilfe der Kontextfilterung nur relevante Passagen an das Modell senden, was API-Kosten senkt und Antworten besser verankert.
Agenten mit präzisem, belegtem Kontext versorgen, damit Antworten Quellen nennen und Halluzinationen sinken.
Mit der kostenlosen Teststufe starten, die Qualität per Browser-Demo validieren und dann auf nutzungsbasierte Produktion umsteigen.
Direkter Telemetrievergleich konkurrierender KI-Tools in derselben Hauptkategorie
| Rang | KI-Tool | Monatliche Besuche | MoM-Wachstum | Anteil direkter Zugriffe | Preise | Direktvergleich |
|---|---|---|---|---|---|---|
| ● | Ducky | 1966 | -8,4 % | 39% direkt | Freemium | Aktuell |
| 1 | Jina AI | 280.782 | -16,5 % | 51% direkt | Freemium, Kostenpflichtig | vs Jina AI |
| 2 | Pinecone | 286.732 | -31 % | 41% direkt | Freemium, Kostenpflichtig, Preise auf Anfrage | vs Pinecone |
| 3 | Zilliz | 108.886 | -16,4 % | 34% direkt | Freemium, Paid, Free, Contact for Pricing | vs Zilliz |
| 4 | Algolia | 689.970 | -11 % | 49% direkt | Freemium, Preise auf Anfrage | vs Algolia |
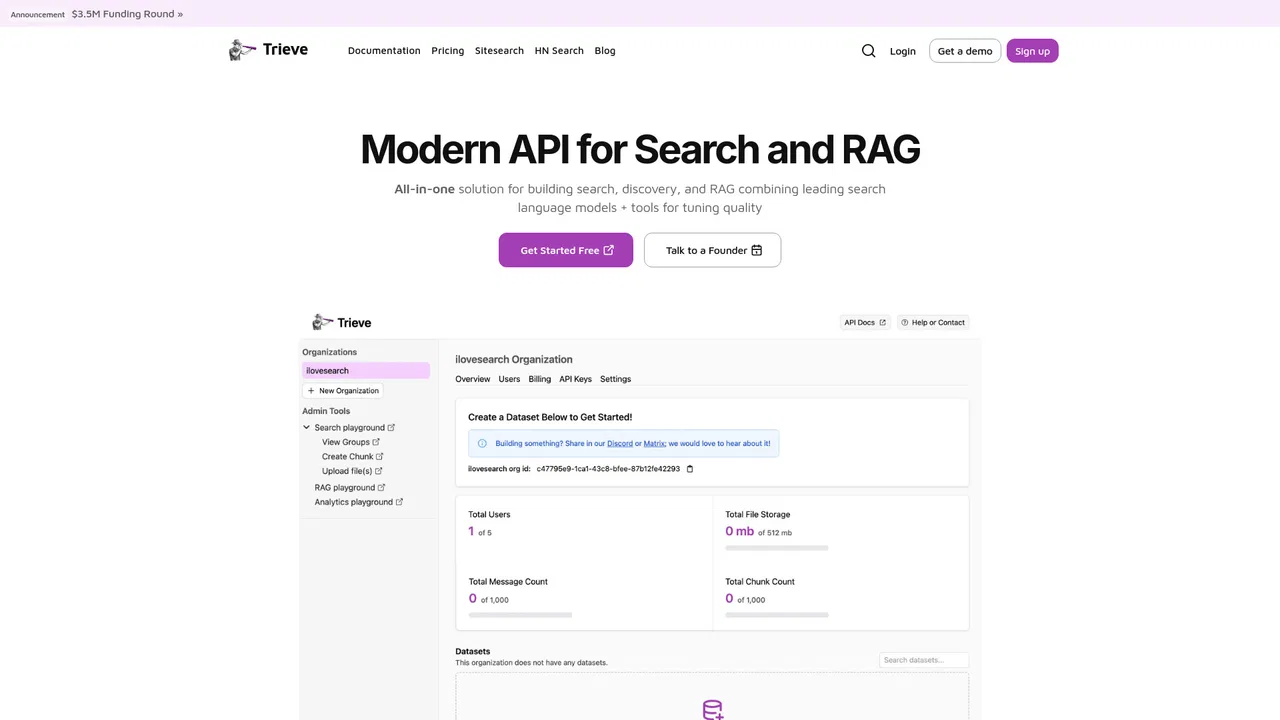
| 5 | Trieve | 1946 | -12,4 % | 39% direkt | Preise auf Anfrage | vs Trieve |
| 6 | Ragie | 7557 | -26,8 % | 40% direkt | Freemium, Kostenlose Testversion, Kostenlos | vs Ragie |
Eine Suchbasis aus Embeddings, Rerankern und Reader-APIs
SpezialisiertPinecone is a managed vector database and AI knowledge platform for building retrieval-augmented generation (RAG), semantic search, and agent memory. It stores vector embeddings at scale, makes writes searchable within seconds with no index tuning, and keeps p99 latency steady as data grows. Pinecone powers products for more than 10,000 customers and over a million developers worldwide.
SpezialisiertPinecone is a managed vector database and AI knowledge platform for building retrieval-augmented generation (RAG), semantic search, and agent memory. It stores vector embeddings at scale, makes writes searchable within seconds with no index tuning, and keeps p99 latency steady as data grows. Pinecone powers products for more than 10,000 customers and over a million developers worldwide.

Zilliz is the company behind Milvus, the open-source vector database, and offers Zilliz Cloud — a fully managed vector database service built for large-scale AI retrieval, RAG, and similarity search workloads.
Zilliz is the company behind Milvus, the open-source vector database, and offers Zilliz Cloud — a fully managed vector database service built for large-scale AI retrieval, RAG, and similarity search workloads.
SpezialisiertKI-Suche und Retrieval-Plattform für moderne Apps und Commerce
SpezialisiertKI-Suche und Retrieval-Plattform für moderne Apps und Commerce

Kostenlos / Open SourceTrieve is an AI search and discovery platform and open API for building RAG applications. It combines hybrid search, chunk management, conversational AI and relevance analytics in one system, and can be used as a managed service or self-hosted.
Kostenlos / Open SourceTrieve is an AI search and discovery platform and open API for building RAG applications. It combines hybrid search, chunk management, conversational AI and relevance analytics in one system, and can be used as a managed service or self-hosted.

SpezialisiertDie gemanagte Context Engine für Agenten, Assistenten und Apps
Kostenlos / Open SourceOpen-Source-RAG-Plattform für verlässlichen KI-Chat und Suche
Kostenlos / Open SourceOpen-Source-RAG-Plattform für verlässlichen KI-Chat und Suche

SpezialisiertExa is a search API and web research tool designed for AI applications. It gives agents clean, structured, real-time web data with semantic search, crawling, enrichment and deep research from a single endpoint.
SpezialisiertExa is a search API and web research tool designed for AI applications. It gives agents clean, structured, real-time web data with semantic search, crawling, enrichment and deep research from a single endpoint.
SpezialisiertBocha AI Search is a search engine built for AI applications. It returns clean, accurate, high-quality web results that AI agents and LLM apps can consume directly, and it ships with multimodal vertical agents for restaurants, hotels, attractions, flights, academic papers, and document libraries.
SpezialisiertBocha AI Search is a search engine built for AI applications. It returns clean, accurate, high-quality web results that AI agents and LLM apps can consume directly, and it ships with multimodal vertical agents for restaurants, hotels, attractions, flights, academic papers, and document libraries.
SpezialisiertSuch- und Inferenz-APIs, die KI-Modellen Echtzeit-Webdaten liefern
SpezialisiertSuch- und Inferenz-APIs, die KI-Modellen Echtzeit-Webdaten liefern
Kostenlos / Open SourceQdrant is an open-source vector search engine and database, written in Rust, for high-performance similarity search in AI applications.
Kostenlos / Open SourceQdrant is an open-source vector search engine and database, written in Rust, for high-performance similarity search in AI applications.

Die Relevanz-Engine mit integrierter Feedback-Schleife