로딩 중…
모든 문서를 AI에 바로 쓰는 Markdown 또는 구조화된 JSON으로 변환
월간 방문 수
5.18만
월간 방문 수
5.18만
전월 대비 성장
+1.67만
상승 속도: +47.4%
직접 유입 비중
40%
직접 유입 비중은 사용자 유지율이 아닙니다.
주요 시장
🇺🇸미국
점유율: 16.3%
트래픽 추이
월간 웹사이트 방문 수 추정치
https://monkt.com
라이브 사이트 열기 모든 문서를 AI에 바로 쓰는 Markdown 또는 구조화된 JSON으로 변환
월간 웹사이트 방문 수 추정치
이 도메인의 Similarweb 추정치이며 활성 사용자 수가 아닙니다. 관측 데이터가 있는 월만 표시하며 수집일과 집계 월을 구분합니다.
수집일 2026. 11. 11.

에디터가 매긴 5점 만점 평가이며, 사용자 평점의 평균이 아닙니다. 이 페이지의 관점들은 제품 정보를 바탕으로 AI가 정리한 것이며, 실제 사용자 후기가 아닙니다.
2026-11-11에 검증된 OpenAITools.app 텔레메트리에 따르면, Monkt(monkt.com)은(는) AI 문서 추출에 색인된 AI 플랫폼으로 월 5.18만회 방문을 기록 중이며, 전월 대비 트래픽 변화량은 +1.67만(+47.4%)입니다. 주요 지리적 시장은 미국(트래픽 점유율 16.3%)이며, 유료 가격 모델로 운영됩니다. 월간 트래픽 기준 주요 경쟁 대안으로는 Datalab (월 7.34만회 방문), AnyParser (월 4.76천회 방문), Firecrawl (월 182.82만회 방문) 등이 있습니다.
RAG 구축할 때 문서 전처리가 너무 편해졌음.
API 속도 빠르고 포맷 깔끔함.
실제 사이트 점검, 요금 구조, 동일 카테고리 기준을 바탕으로 AI가 재구성한 참고 관점이며 개별 실사용자의 후기가 아닙니다.
문서를 LLM 친화적인 깔끔한 Markdown으로, 또는 자동 감지나 직접 정의한 스키마에 맞춘 JSON으로 변환합니다.
PDF, Word, PowerPoint, Excel, CSV, 이미지, 웹페이지와 원시 HTML을 처리하며 문서 구조와 서식을 유지합니다.
스캔 문서에서 텍스트를 추출하고 문서 내 이미지와 도표를 설명 텍스트와 구조화 데이터로 변환합니다.
변환을 프로그래밍 방식으로 실행하고 여러 문서를 동시에 처리해 데이터셋 준비와 파이프라인 자동화를 확장합니다.
상위 티어는 고급 추출, 페이지 레이아웃, 읽기 순서, 표 구조 이해와 GPU 가속 추론을 제공합니다.
Monkt는 AI 스택에서 매우 구체적인 문제를 해결합니다. 바로 지저분한 문서를 언어 모델이 실제로 쓸 수 있는 형식으로 만드는 일입니다. 손으로 옮겨 적는 대신 파일을 올리거나 URL을 넘기면 구조와 서식이 보존된 표준 Markdown, 또는 직접 정의한 스키마에 맞춘 JSON을 받습니다. PDF, Word, PowerPoint, Excel, CSV, HTML을 지원하고 OCR로 이미지와 스캔 페이지를 읽으며, 시각적 내용을 텍스트로 설명해 문서 속 도표도 변환 후에 살아남습니다.
단순 변환을 넘어 자사 콘텐츠 위에 지능형 애플리케이션을 구축하는 기반으로도 자리매김합니다. 구조화 출력은 맞춤 챗봇, 시맨틱 지식 베이스, 문서 인텔리전스 워크플로, 파인튜닝 데이터셋에 연결됩니다. REST API는 동일한 파이프라인을 프로그래밍 방식으로 대규모 실행하게 하고, 일괄 처리는 밀린 문서를 한 번에 정리합니다. 회사는 수천 명의 사용자를 대상으로 100만 건 이상의 문서를 처리했다고 밝힙니다.
가격은 의도적으로 단순합니다. 저가 개인 플랜, DeepExtract 처리와 스캔 문서 OCR, 더 긴 데이터 보존을 추가한 프로 플랜, GPU 추론과 레이아웃·읽기 순서 이해, 맞춤 연동 지원, 확장 컨텍스트를 갖춘 엔터프라이즈가 있습니다. 별도로 대량 처리, 지능형 청킹, 벡터화, RAG 최적화 데이터 준비를 대행하는 프리미엄 서비스는 요청당 견적으로 제공됩니다.
PDF와 웹페이지 모음을 깔끔한 Markdown으로 바꾸고 청킹·인덱싱해 검색 증강 생성 파이프라인에 투입합니다.
JSON 스키마를 정의해 논문, 재무 보고서, 양식에서 일관된 필드를 대량 추출하고 스캔본은 OCR로 처리합니다.
제품 문서와 헬프센터 콘텐츠를 맞춤 챗봇이나 시맨틱 검색 뒤의 구조화 입력으로 전환합니다.
깔끔하고 형식이 일관된 텍스트와 JSON을 대규모로 만들어 특화 언어 모델 학습이나 파인튜닝에 활용합니다.
동일한 주요 카테고리에 속한 경쟁 AI 도구의 나란히 보는 텔레메트리 비교
| 순위 | AI 도구 | 월간 방문 수 | 전월 대비 성장률 | 직접 유입 비중 | 가격 | 일대일 비교 |
|---|---|---|---|---|---|---|
| ● | Monkt | 5.18만 | +47.4% | 직접 유입 40% | 유료 | 현재 도구 |
| 1 | Datalab | 7.34만 | +66% | 직접 유입 52% | 무료+유료, 가격 문의 | vs Datalab |
| 2 | AnyParser | 4.76천 | -14.9% | 직접 유입 40% | 무료 체험, 가격 문의 | vs AnyParser |
| 3 | Firecrawl | 182.82만 | -1.9% | 직접 유입 40% | 무료+유료, 가격 문의 | vs Firecrawl |
| 4 | Reducto | 9.21만 | +0.9% | 직접 유입 46% | 무료+유료 | vs Reducto |
| 5 | Airparser | 3.47만 | -9.5% | 직접 유입 40% | 무료+유료, 무료 체험, 유료 | vs Airparser |
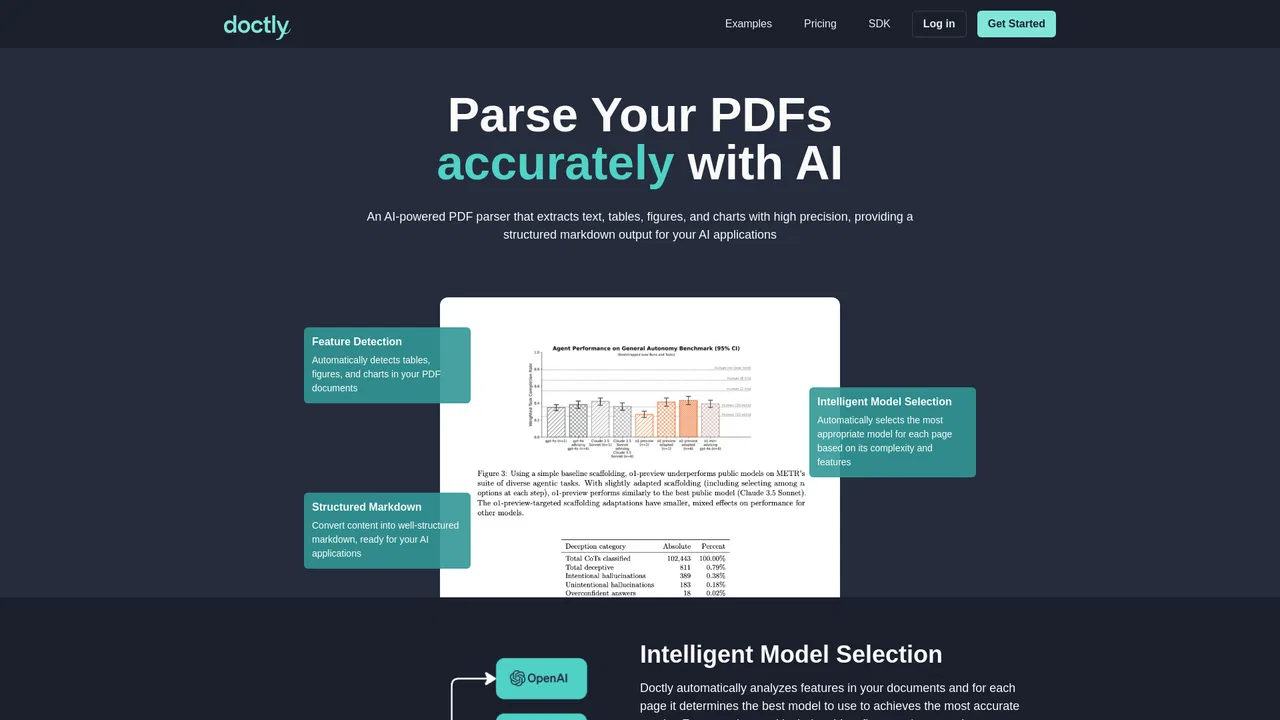
| 6 | Doctly AI | 595 | -79.8% | 직접 유입 39% | 무료+유료 | vs Doctly AI |
무료 / 오픈소스AnyParser by CambioML turns PDFs, presentations, images and web pages into clean, structured, LLM-ready data while keeping sensitive values protected. It is designed for teams that need reliable extraction, not just a demo.
무료 / 오픈소스모든 웹사이트를 AI가 바로 쓸 수 있는 데이터로 바꾸는 웹 데이터 API

무료 / 오픈소스복잡한 PDF를 LLM이 바로 쓸 수 있는 구조화 데이터로 바꾸는 에이전트형 문서 플랫폼
무료 / 오픈소스이메일·PDF·문서를 구조화된 JSON으로 변환하는 LLM 기반 파서
무료 / 오픈소스PDF를 구조화된 데이터로 변환하고, 문서와 대화하며, 문서 워크플로를 자동화합니다

무료 / 오픈소스Veryfi is a document intelligence platform built around OCR and multi-modal extraction APIs that turn invoices, receipts, bank statements, checks and 100+ other document types into structured data, with on-device capture SDKs and real-time fraud detection included in the same API responses.
무료 / 오픈소스Veryfi is a document intelligence platform built around OCR and multi-modal extraction APIs that turn invoices, receipts, bank statements, checks and 100+ other document types into structured data, with on-device capture SDKs and real-time fraud detection included in the same API responses.

무료 / 오픈소스에이전트 기반 파싱과 추출로 모든 문서를 AI가 쓸 수 있는 컨텍스트로

특화 강점Upstage builds enterprise-grade large language models and document AI engines, including Solar LLMs, Document Parse, Information Extract and an agent studio for document workflows.
특화 강점Upstage builds enterprise-grade large language models and document AI engines, including Solar LLMs, Document Parse, Information Extract and an agent studio for document workflows.