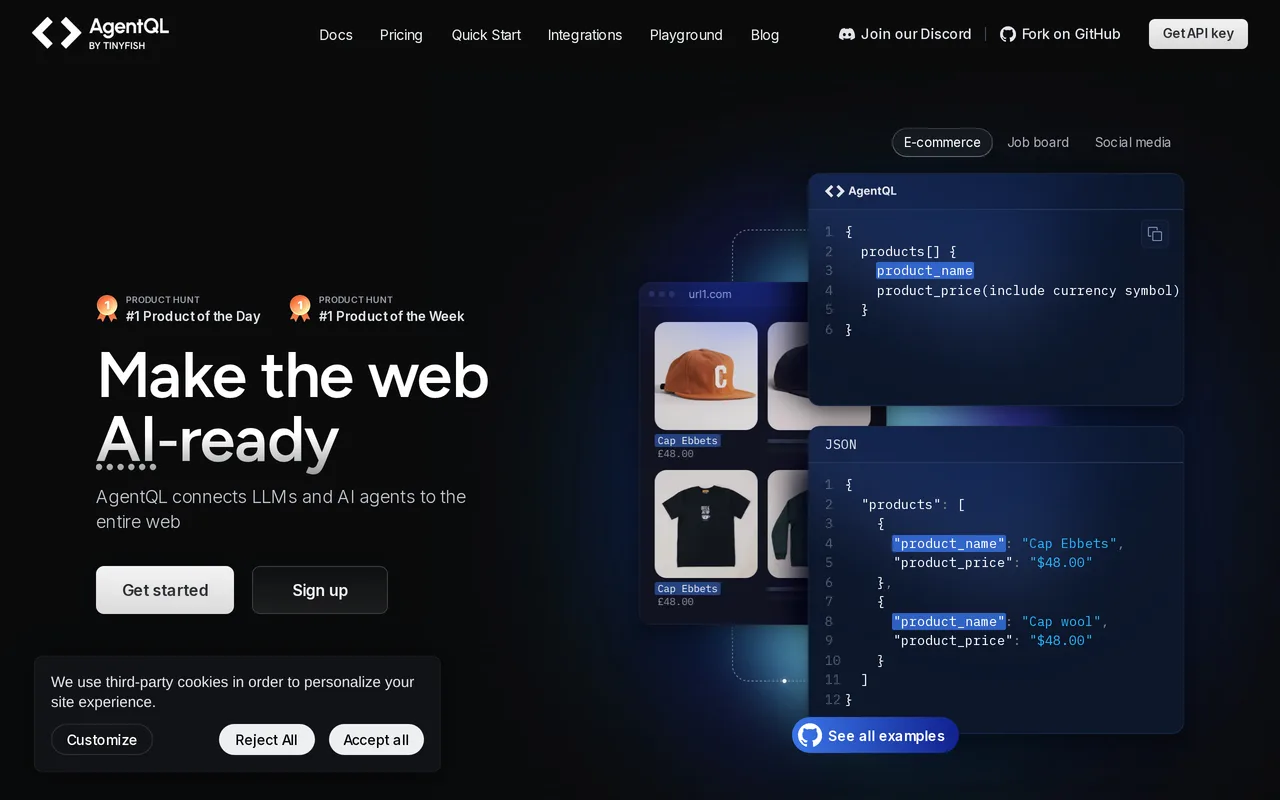
TinyFish se présente comme la stack web des agents d'IA : une plateforme sans serveur qui permet aux agents de chercher, extraire, naviguer et agir sur le web en direct. Ce n'est pas un outil isolé mais plusieurs produits regroupés sous une même clé d'API et un même portefeuille : TinySearch renvoie une recherche fraîche rendue par navigateur sous forme de JSON structuré, TinyFetch transforme n'importe quelle URL en Markdown, JSON ou HTML économes en tokens, TinyBrowser propose de vraies sessions de navigateur cloud pilotables avec Playwright, Puppeteer ou CDP, TinyAgent exécute des automatisations multi-étapes à partir d'un objectif en langage naturel et TinyMonitor alerte lorsqu'une page ou un thème change.
La plateforme vise des charges de production, pas des démonstrations. Elle met l'accent sur la fiabilité et la structure, un rendu par navigateur réel plutôt que des résultats en cache trop légers, la persistance de l'état de session et la prise en charge des flux authentifiés. En complément : TinyVault, qui connecte 1Password ou Bitwarden afin que les identifiants n'atteignent jamais le modèle, TinyProfiles pour conserver les sessions connectées, et des enregistrements pas à pas de chaque exécution pour auditer ce que l'agent a fait sur un site.
TinyFish est conçu pour s'intégrer aux stacks de développement existants. Il est promu pour un usage avec Claude, ChatGPT, Cursor et d'autres runtimes d'agents, propose une connexion MCP, un SDK Python et une CLI, et cible des cas comme la surveillance des prix, l'enrichissement de données, la recherche approfondie et l'automatisation de portails fournisseurs. La recherche et l'extraction de base sont gratuites, tandis que les étapes d'agent, les minutes de navigateur et les vérifications de surveillance sont facturées à l'usage depuis un portefeuille prépayé, avec une offre entreprise pour les déploiements importants.